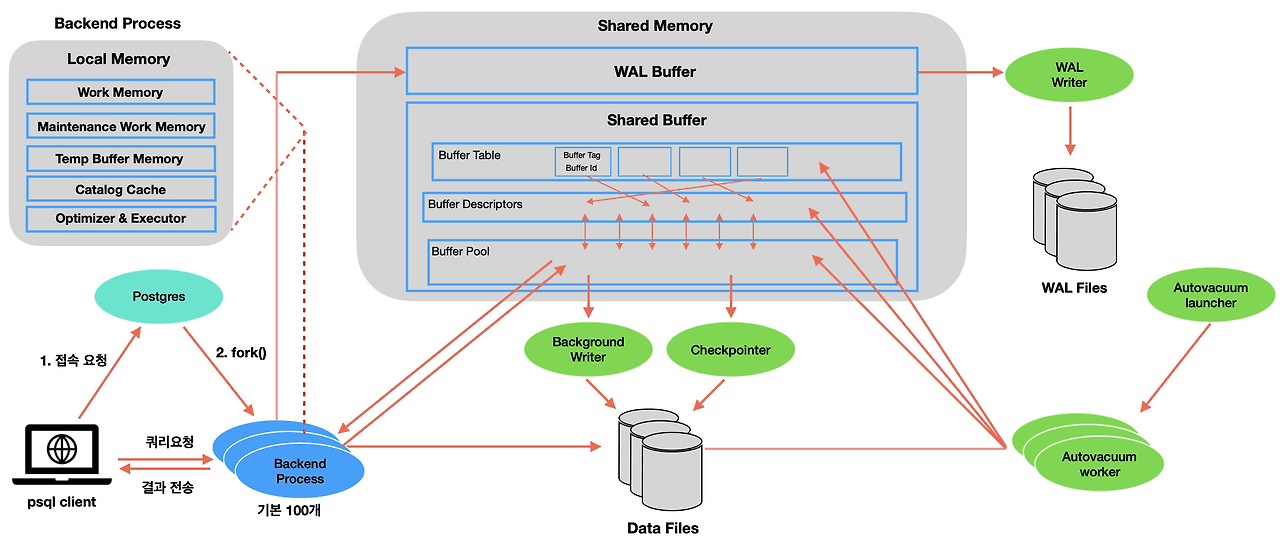
PostgreSQL 프로세스·공유 메모리·파일 구조
PostgreSQL은 물리적으로 나누면 세 영역으로 볼 수 있다.
- 프로세스: PostgreSQL 내부 처리, 운영 작업 그리고 클라이언트 요청 수행
- PostgreSQL process: 메인 프로세스
- Backend process: 클라이언트가 보낸 쿼리를 처리하는 프로세스
- Background process: DB가 안정적이고 효율적으로 동작하도록 뒤에서 일하는 프로세스
- 공유 메모리: 여러 프로세스가 함께 사용하는 캐시와 상태 영역
- 파일: 테이블, 인덱스, WAL 등이 실제로 저장되는 디스크 영역
프로세스
PostgreSQL Process
예전에는
postmaster라고 불렸다.
PostgreSQL 클러스터가 시작되면 가장 먼저 뜬다.
- 공유 메모리 초기화
- 이전에 비정상 종료가 있었다면 crash recovery 수행
- background process 실행
- 클라이언트 연결 수락, 연결마다 backend process 수행
Backend Process
클라이언트가 보낸 SQL을 실제로 처리한다.
- 연결 하나당 하나의 backend process 할당
- 하나의 process가 한 시점에 하나의 쿼리 실행
- 연결이 살아 있으면 사라지지 않고
idle상태로 다음 명령 대기
idle과 idle in transaction의 차이점
idle: 쿼리와 트랜잭션이 끝난 뒤 다음 요청을 기다리는 정상 연결idle in transaction:BEGIN이후 이전 쿼리는 끝났지만 다음 명령을 기다리며 트랜잭션을 열어 둔 상태- 트랜잭션 안에서 외부 API를 호출하는 경우 등에서 발생할 수 있다.
Background Process
Checkpointer
checkpoint를 수행한다.
checkpoint: 특정 시점 이전의 변경 사항이 파일(테이블, 인덱스, 데이터)에 반영됐음을 보장하는 지점
- checkpoint 시작 시점 기준으로 대상이 된 dirty page를 데이터 파일에 기록하고, fsync 완료까지 보장
fsync=on기준- checkpoint 도중 새로 수정된 page는 다음 checkpoint 대상
- checkpoint record와 redo 시작 위치를 WAL에 기록한다. 이는 복구 기준점이 된다.
- 완료된 checkpoint 위치를
pg_control에 기록한다. 재시작 시 마지막 checkpoint를 알려주는 인덱스 역할을 한다.
pg_control은 dirty page 반영이 끝난 뒤에 갱신한다.
Background writer
주기적으로 깨어나서 backend process가 buffer를 얼마나 새로 필요로 했는지 확인하고, 부족해질 만큼 clean buffer를 미리 만들어 둔다.
clean buffer가 부족해지면 backend process가 직접 write를 해야 한다.
-> 요청 지연
- 성능을 위한 선제 작업
- write한 데이터가 물리 디스크까지 durable하게 보장됐는지를 책임지지는 않는다.
WAL writer
WAL buffer에 쌓인 변경 로그를 주기적으로 WAL 파일에 기록한다.
일반적으로 COMMIT의 내구성을 위해서는 커밋 성공 응답 전에 레코드를 durable storage까지 flush한다.
-> synchronous_commit=on
WAL fsync 지연이 COMMIT 완료를 늦춰 트랜잭션이 잡고 있는 row/table lock 해제도 느려질 수 있다.
-> 다른 트랜잭션의 lock 대기를 유발할 수 있다.
메모리
Shared Buffers
여러 PostgreSQL 프로세스가 함께 사용하는 데이터 페이지 캐시다.
- 쿼리 결과 자체를 캐싱하는 공간이 아니라, 테이블과 인덱스 같은
데이터 페이지를 캐싱한다. - 테이블과 인덱스는 보통 8KB 페이지 단위로 다룬다.
- 데이터를 읽을 때 먼저 Shared Buffers에 해당 페이지가 있는지 확인한다.
- 있으면 메모리에서 읽는다.
- 없으면 데이터 파일에서 읽어서 Shared Buffers에 적재한다.
- 수정되면 Shared Buffers에서 수정되고 dirty page로 간주한다.
디스크 I/O를 줄이는 것이다.
PostgreSQL은 Shared Buffers만 사용하는 것이 아니라 OS page cache도 함께 활용한다.
->shared_buffers를 무조건 서버 메모리 대부분으로 잡으면 안 된다!
Dirty Page
Shared Buffers의 페이지 내용이 데이터 파일의 페이지보다 최신인 상태다.
UPDATE,DELETE,INSERT가 Shared Buffers의 page를 수정한 상태- 데이터 파일에 write된 뒤 해당 buffer는 clean 상태가 되어 재사용 가능
- 메모리에서 즉시 제거되지는 않으며, 필요할 때 다른 page로 교체되어도 문제가 없다.
- background writer, backend process, checkpointer가 데이터 파일에 write한다.
WAL Buffers
데이터 변경 로그를 WAL 파일에 쓰기 전 잠시 저장하는 공유 메모리다.
- Write-Ahead Logging
- WAL 레코드는 데이터 변경을 복구할 수 있는 정보와 커밋 정보를 기록한다.
- WAL writer가 WAL Buffers를 주기적으로 write하고 flush한다.
UPDATE가 동작하는 흐름
- Backend process가 Shared Buffers의 data page를 수정한다.
- 페이지는 데이터 파일보다 최신이므로 dirty page가 된다.
- 변경을 복구할 수 있는 WAL 레코드를 WAL Buffers에 기록한다.
- COMMIT 시 COMMIT 레코드를 WAL Buffers에 기록한다.
- WAL 레코드와 COMMIT 레코드를 WAL 파일에 flush·fsync한 뒤 클라이언트에 응답한다.
synchronous_commit=on인 경우
- dirty page는 background writer, backend, checkpointer에 의해 데이터 파일에 write된다.
- data page를 write하기 전에 관련 WAL은 먼저 flush되어야 한다.
- checkpoint가 checkpoint 시점에 대상 데이터 파일의 fsync 완료를 보장한다.
synchronous_commit=off는 COMMIT 레코드를 WAL Buffers에 넣고 WAL fsync를 기다리지 않고 바로 성공 응답한다.
-> 성공 응답을 받아도 WAL을 안전하게 flush하기 전에 서버가 죽으면 커밋이 유실될 수 있다!
fsync: 메모리 버퍼에 저장된 데이터를 디스크에 강제 기록하고 동기화하는 system call
-> 실제 저장 장치까지 반영될 때까지 호출 프로세스는 동기적으로 blocking된다.